1. 项目背景与挑战
1.1 无人机航拍检测的价值
无人机航拍凭借其极其广阔的视野和灵活的机动性,已在交通疏导、应急救援、农业估产、快递配送等领域发挥着不可替代的作用。然而无人机航拍图像的目标通常具有目标小、像素低、肉眼难以识别等技术挑战。本实验旨在探究在受限算力下,实现无人机航拍图像高精度检测的工程可行性。
1.2 核心难点
本实验选用的 VisDrone 数据集极具挑战性,被业界公认为值得作为目标检测训练的优秀数据集,其数据设置的难点主要体现在以下三个方面:
- 目标极小:在 2000×1500 像素的高空航拍图像中,许多行人、自行车等目标仅有几个像素,考验模型识别肉眼难以分辨目标的能力。
- 目标极度密集:单张图片中最多包含 902 个待检测目标,目标类型不同且各目标之间互相遮挡严重,考验模型在互相遮挡条件下快速分辨不同目标的能力。
- 类别不平衡:该数据集中"汽车"和"行人"占据绝对多数,而"公交车"、"卡车"等类别样本极少,符合实际社会情况的同时也导致了模型的训练变得困难。
1.3 硬件与算力限制
本实验在受限的实验环境中使用个人消费级游戏笔记本(搭载 NVIDIA RTX 5060 8GB 显存)进行。相比较于实验室服务器,消费级显卡面临显存小、散热压力大等现实约束。此外,校园夜间断电导致每晚训练被迫终止。如何在算力硬件受限与供电受限等现实条件下,通过合理的工程策略完成高精度的微调,是本次实验的核心挑战。
2. 数据准备与预处理
2.1 数据集介绍与实验预处理
VisDrone2019 数据集包含 6471 张训练图、548 张验证图和 1610 张测试图。原始标注为 .txt 文本文件,每行代表一个目标的 8 个属性,完整格式为:<bbox_left>, <bbox_top>, <bbox_width>, <bbox_height>, <score>, <object_category>, <truncation>, <occlusion>。该格式无法直接用于 YOLO 训练,因此需要编写脚本对标注进行预处理。
2.2 数据格式转换
本实验通过使用 Python 脚本,将原始标注格式转换为 YOLO 标准格式:<class_id> <x_center> <y_center> <width> <height>。重点完成将像素坐标除以图像的宽高,归一化到 [0, 1] 区间。
需要特别说明的是:本实验保留了 score=0 的"忽略区域"样本参与训练,仅过滤未知类别与无效坐标。这些区域目标极度模糊或被严重遮挡,增加了模型学习难度,但也使模型在实际部署时面对模糊小目标具备更强的特征提取能力。mAP50=0.619 即为保留这些困难样本条件下的保守评估结果。
2.3 类别映射策略
原始数据集包含 10 个类别,本实验将其合并为以下 6 类:person, bicycle, car, motorcycle, bus, truck。
原因说明:因航拍在实际应用中通常相较于识别目标具体是什么类型(例如三轮车和带篷三轮车),更关注找到这个目标。并且在航拍视角下,van 与 car、tricycle 与 motorcycle 视觉高度重叠,强行区分会增加模型的无意义困惑。合并后能显著缓解长尾效应,故将部分类似分类合并转化为同一类别,最终化为六类索引,从而使模型更专注于学习"人"与"车"的核心特征。
3. 实验过程与踩坑复盘
3.1 尝试一:YOLOE 微调(失败)
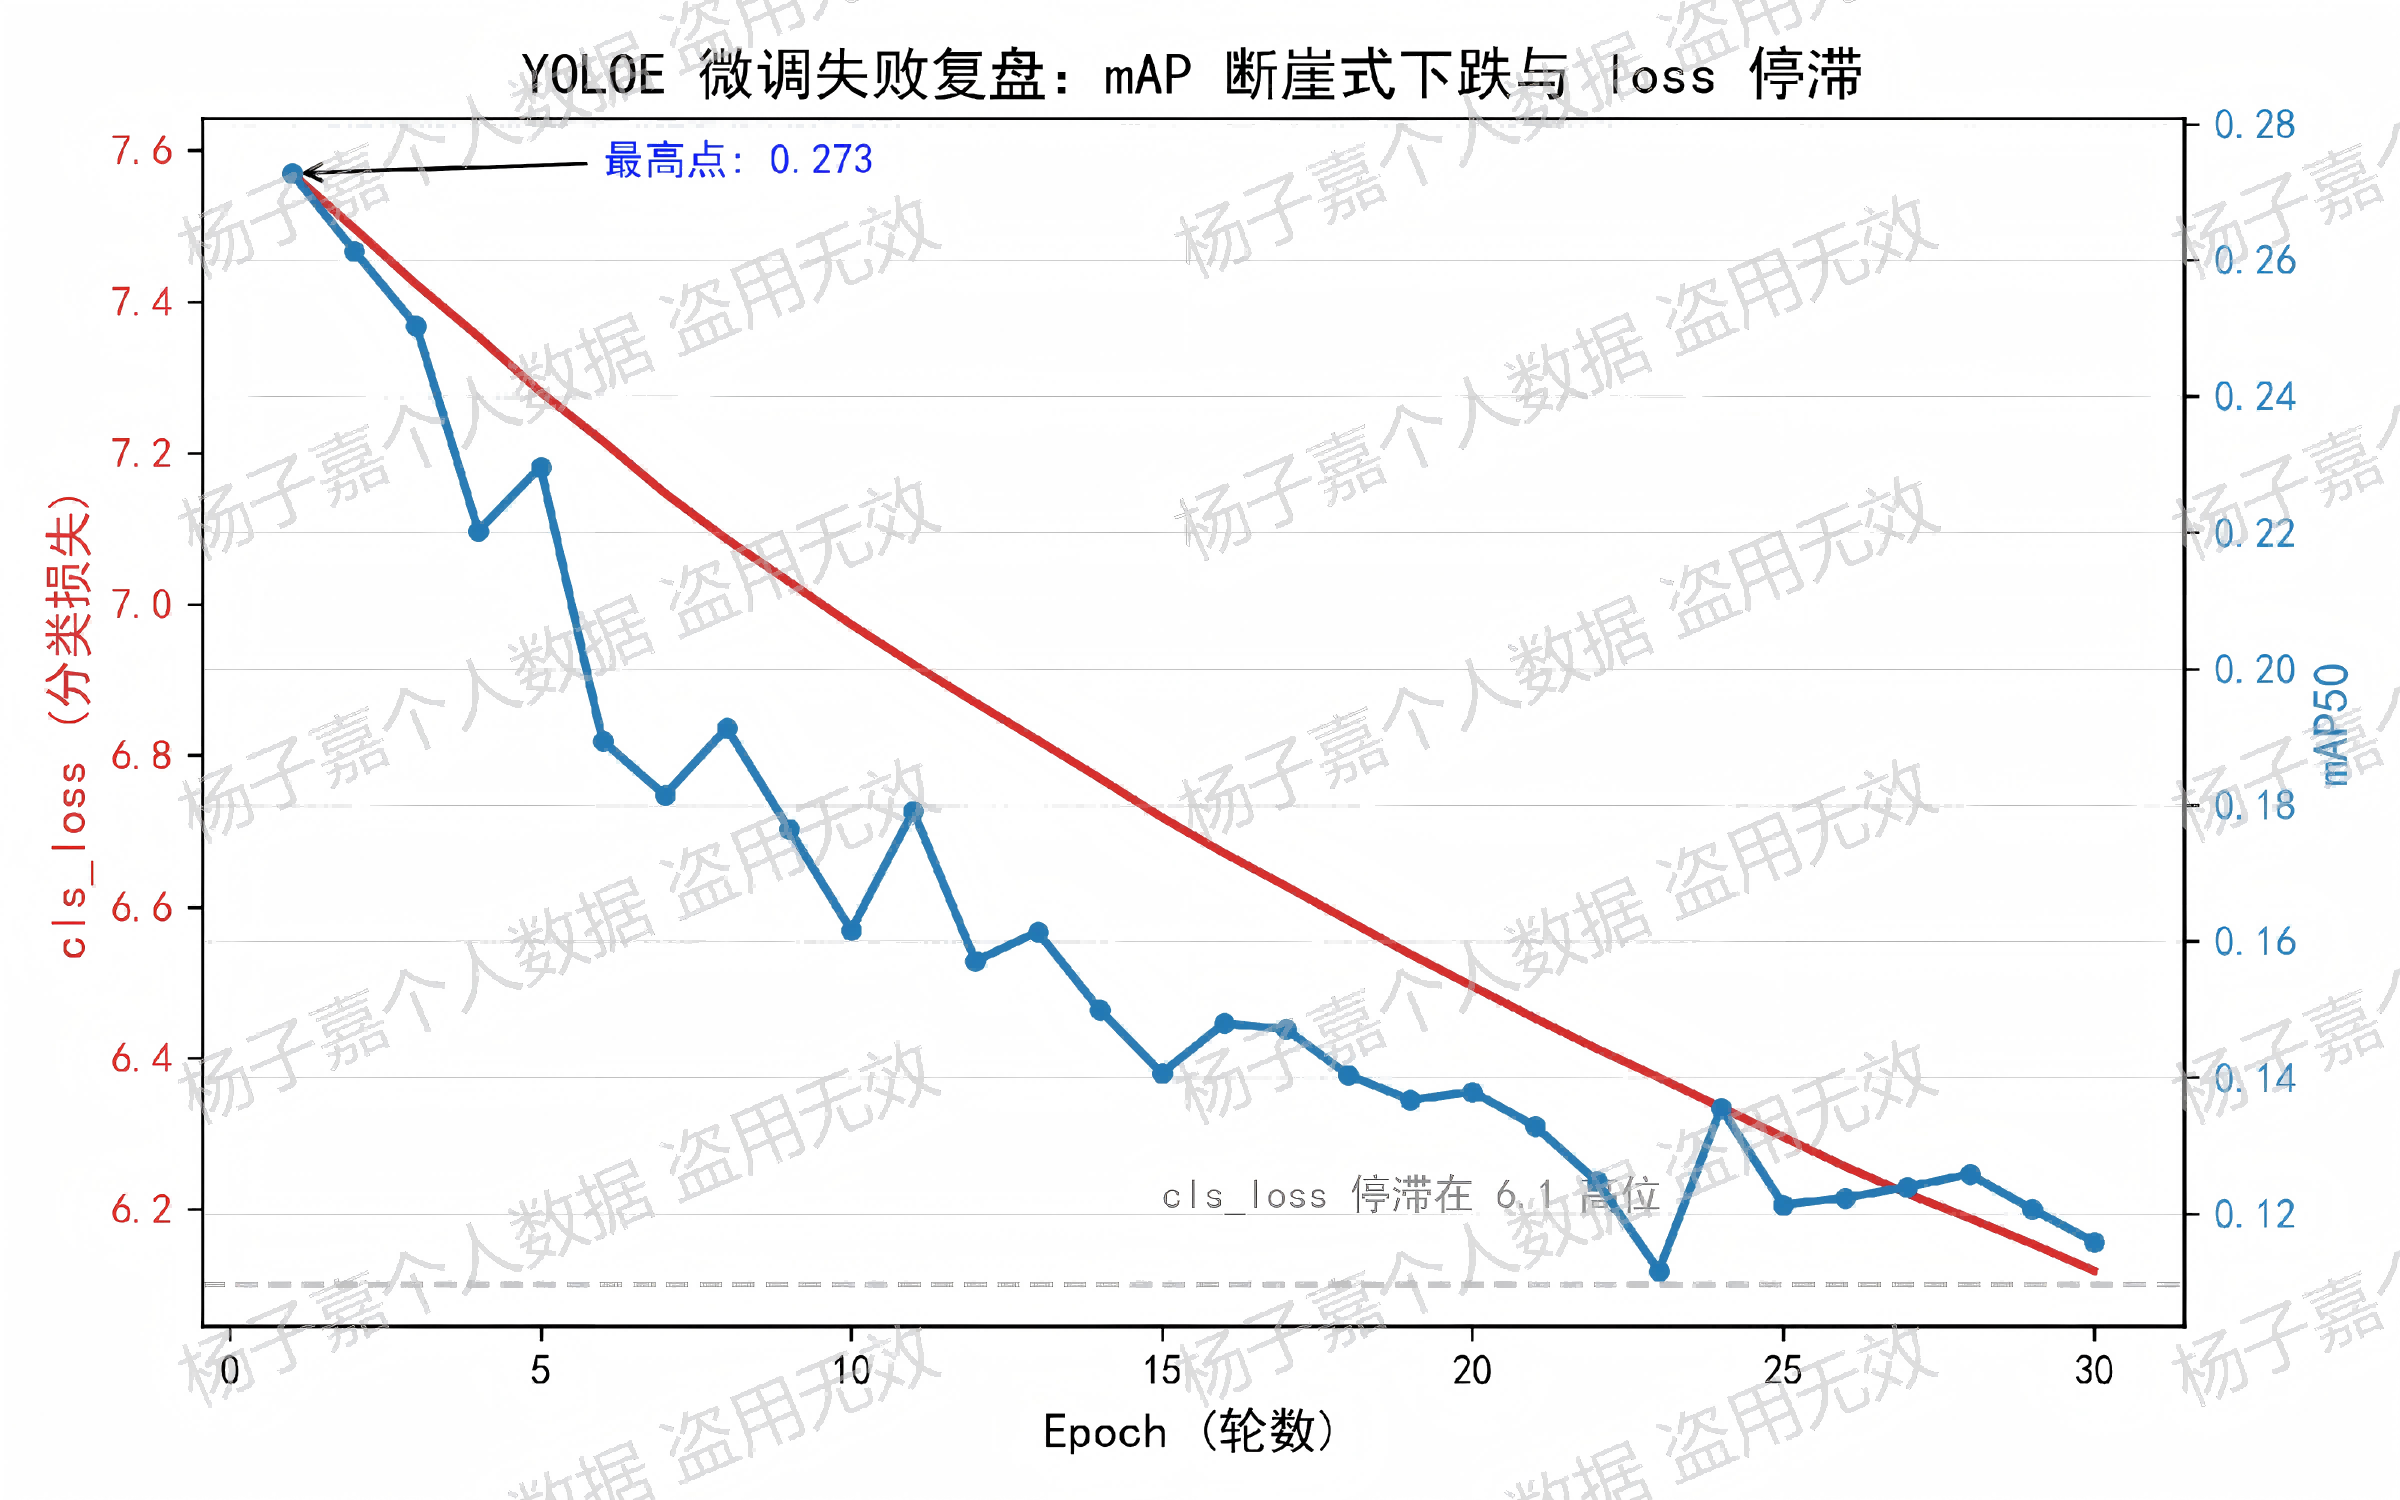
- 配置:YOLOE-11s,lr0=1e-3,AdamW,imgsz=1280。
- 现象:第 1 轮 mAP50 达到 0.273,随后断崖式下跌至 0.12,cls_loss 停滞在 6.1 无法收敛。
- 归因:推测主要原因是微调策略不当引发的灾难性遗忘(Catastrophic Forgetting)。YOLOE 的文本-图像对齐机制对优化超参数较为敏感,直接以 lr0=1e-3 微调可能破坏了预训练权重的分布,导致 cls_loss 无法收敛。
- 结论:考虑到时间与算力成本,果断止损,更换为标准 YOLO 检测架构。
3.2 尝试二:YOLO11s 成功版本
- 模型选择:YOLO11s(9.4M 参数,轻量级现代架构)。
- 显存优化:经历 batch=4 爆显存(9.43G),调整至 batch=2(稳定 4-5G),结合 AMP 混合精度训练。
- 断点续训(热重启):由于断电中断,加载 best.pt 重置优化器状态并引入学习率热重启。首次重启(Epoch 9→10)后 mAP50 从 0.5243 回撤至 0.5232;第二次重启(Epoch 52→53)后从 0.6094 回撤至 0.6015。两次回撤均在数轮内恢复并继续爬升。
- 训练参数:imgsz=1280,batch=2,AdamW,mosaic=1.0,scale=0.9,close_mosaic=10。
4. 实验结果与分析
4.1 整体指标
经过 82 个 epoch 的训练,模型在验证集(6 类合并口径)上达到以下指标:mAP50=0.619;mAP50-95=0.386。
作为参考,公开报道的 YOLO11s 在 VisDrone2019 验证集、640 分辨率、10 类口径下的 mAP50 约为 0.38-0.40。需要指出,两者类别数与评估协议不同,该对比仅用于说明高分辨率微调的收益趋势,不构成严格的同口径比较。
4.2 训练过程曲线
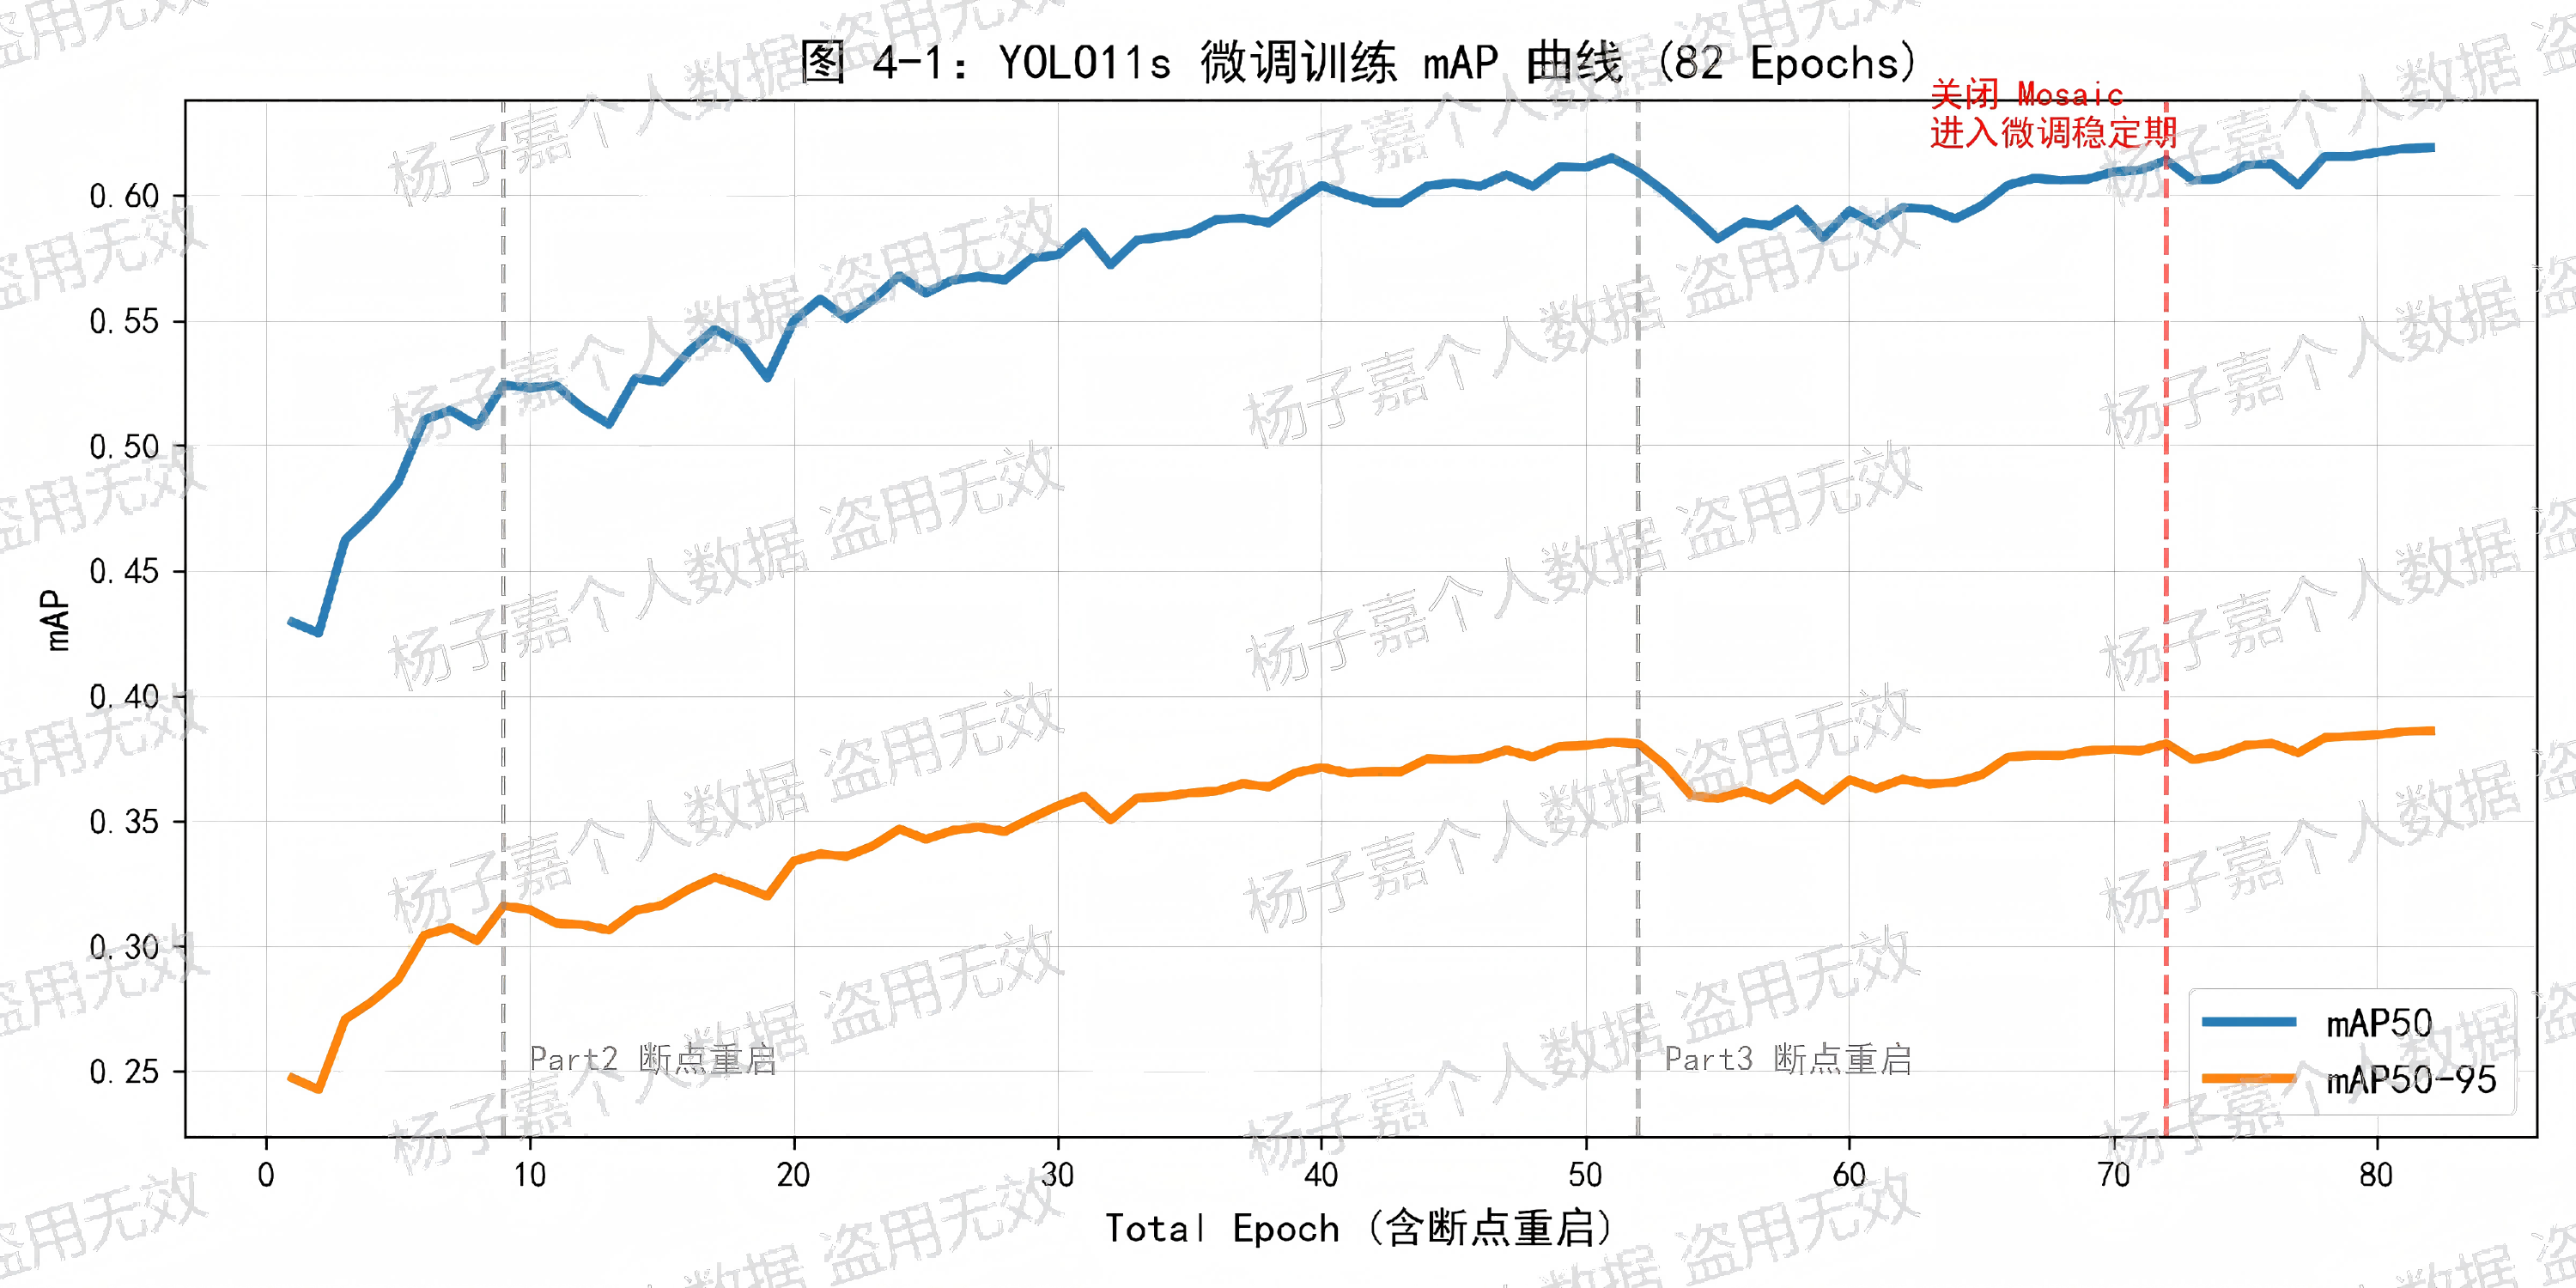
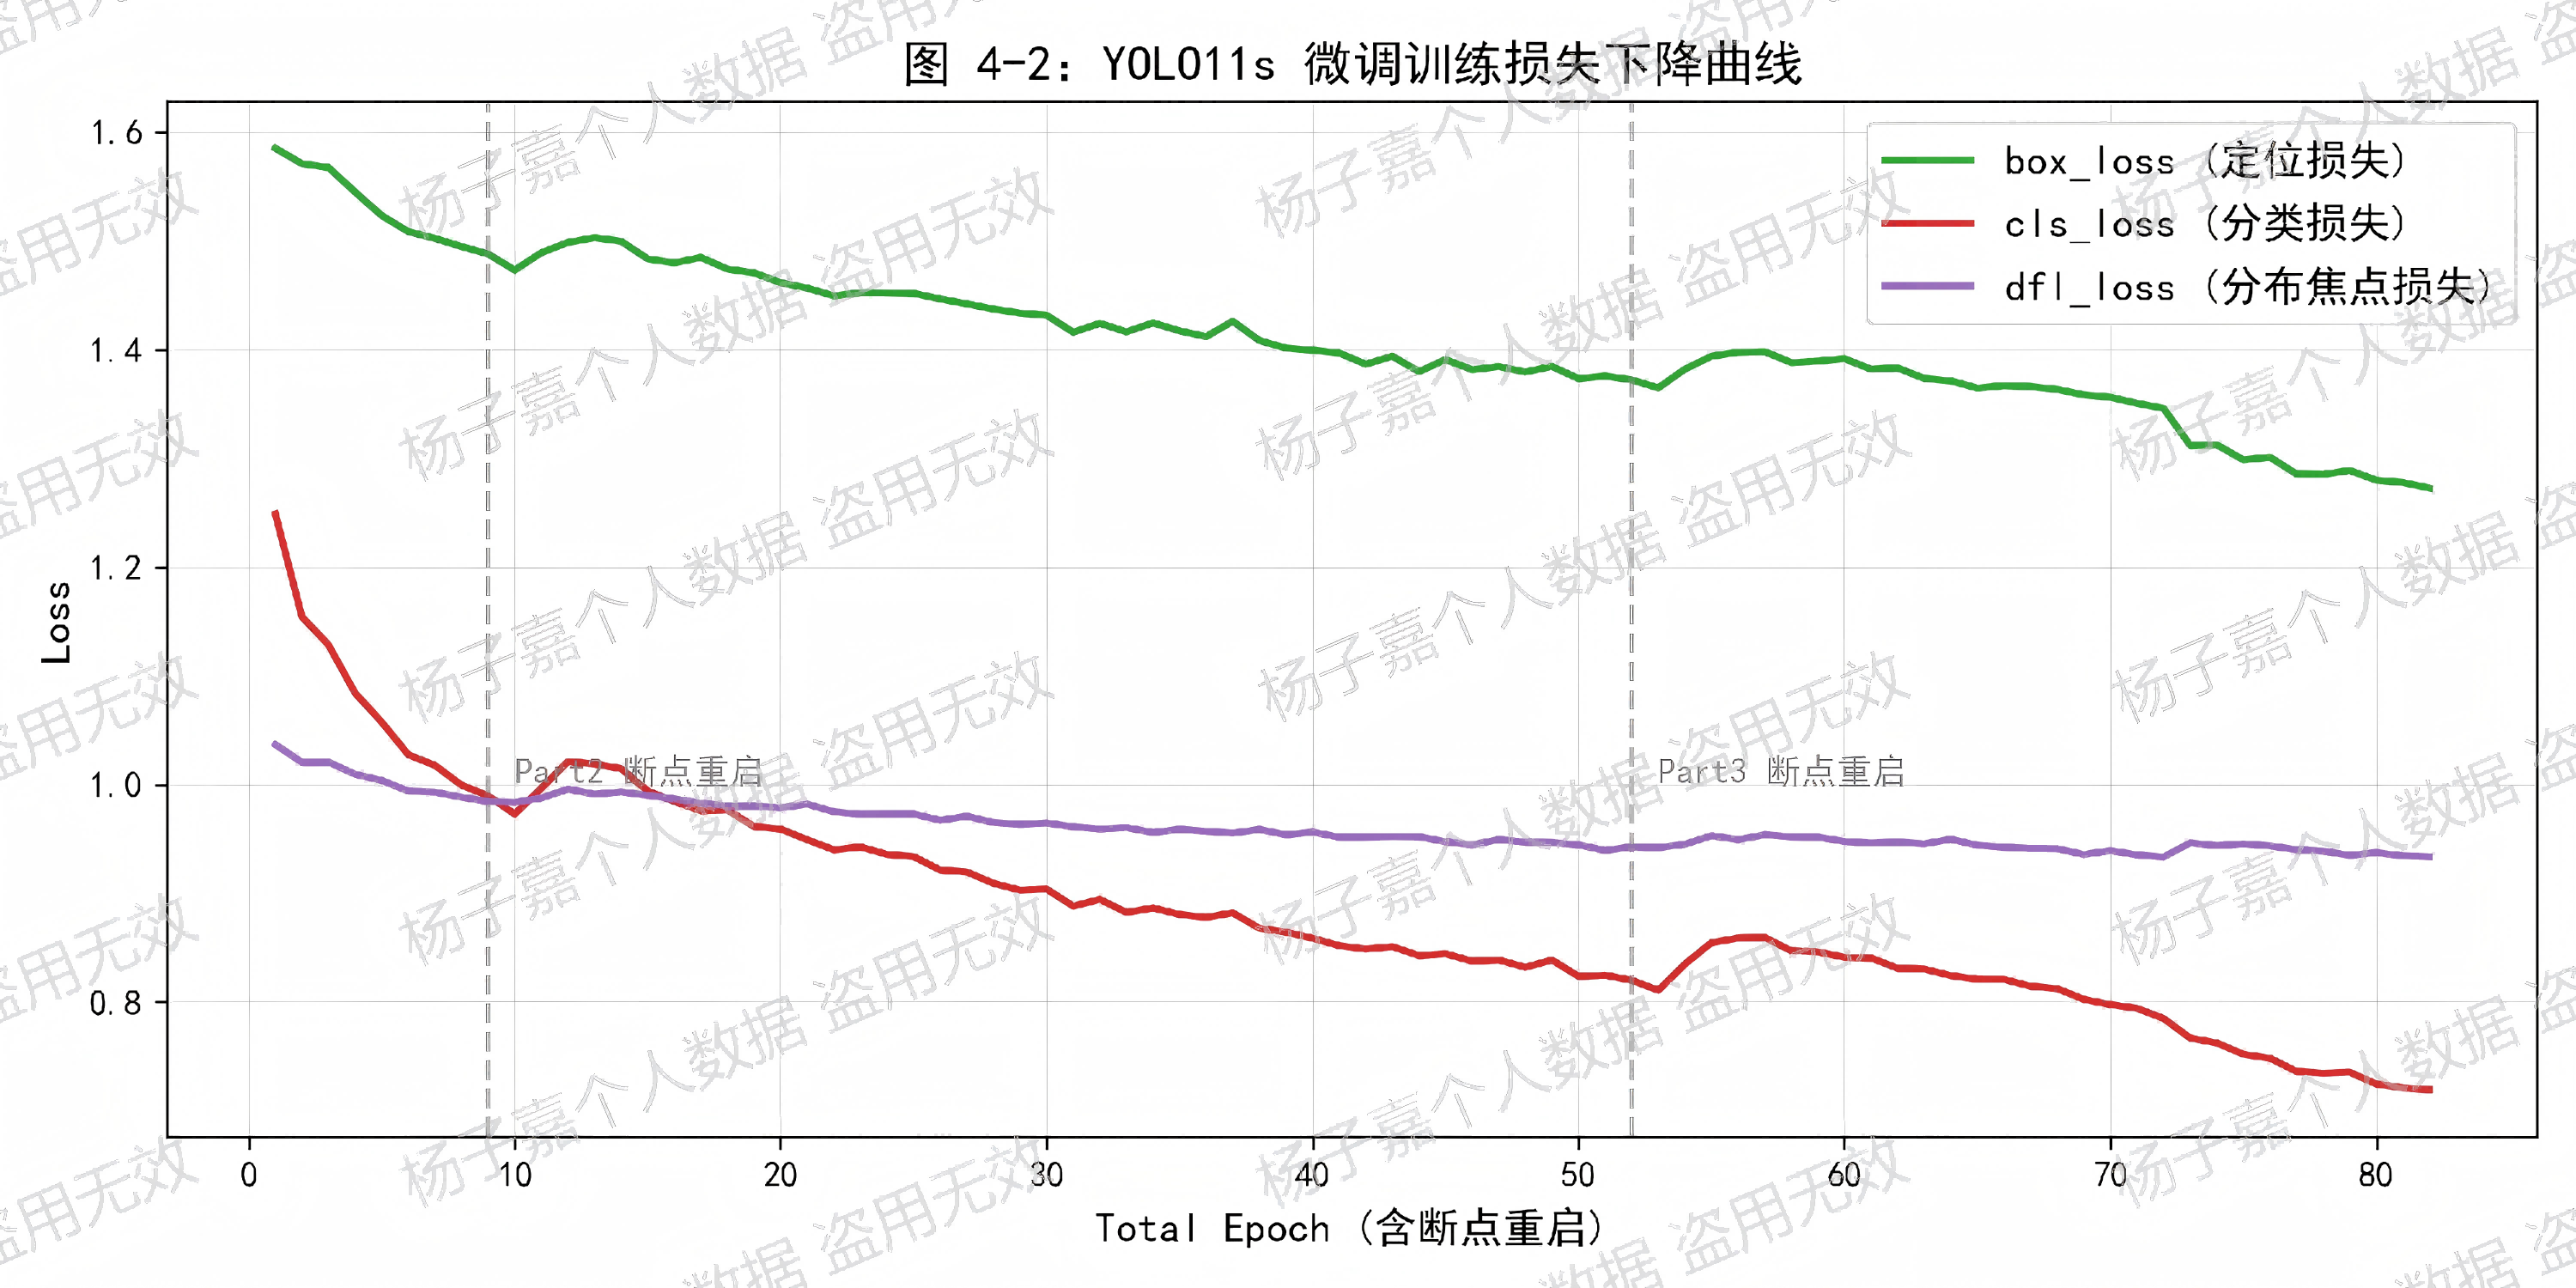
本次实验总共进行了 82 个 epoch 的训练。受外部供电限制,训练过程被断点续训为三个阶段(Epoch 1-9、Epoch 10-52、Epoch 53-82)。
在训练的最后 10 个 epoch(Epoch 73-82),模型触发了 close_mosaic=10 策略,停止使用 Mosaic 畸变增强,转向高清原图进行微调。此时 mAP 曲线呈现极其平滑的收敛态势,最终在 Epoch 82 定格于 mAP50=0.6191、mAP50-95=0.3861 的峰值。
4.3 混淆矩阵分析
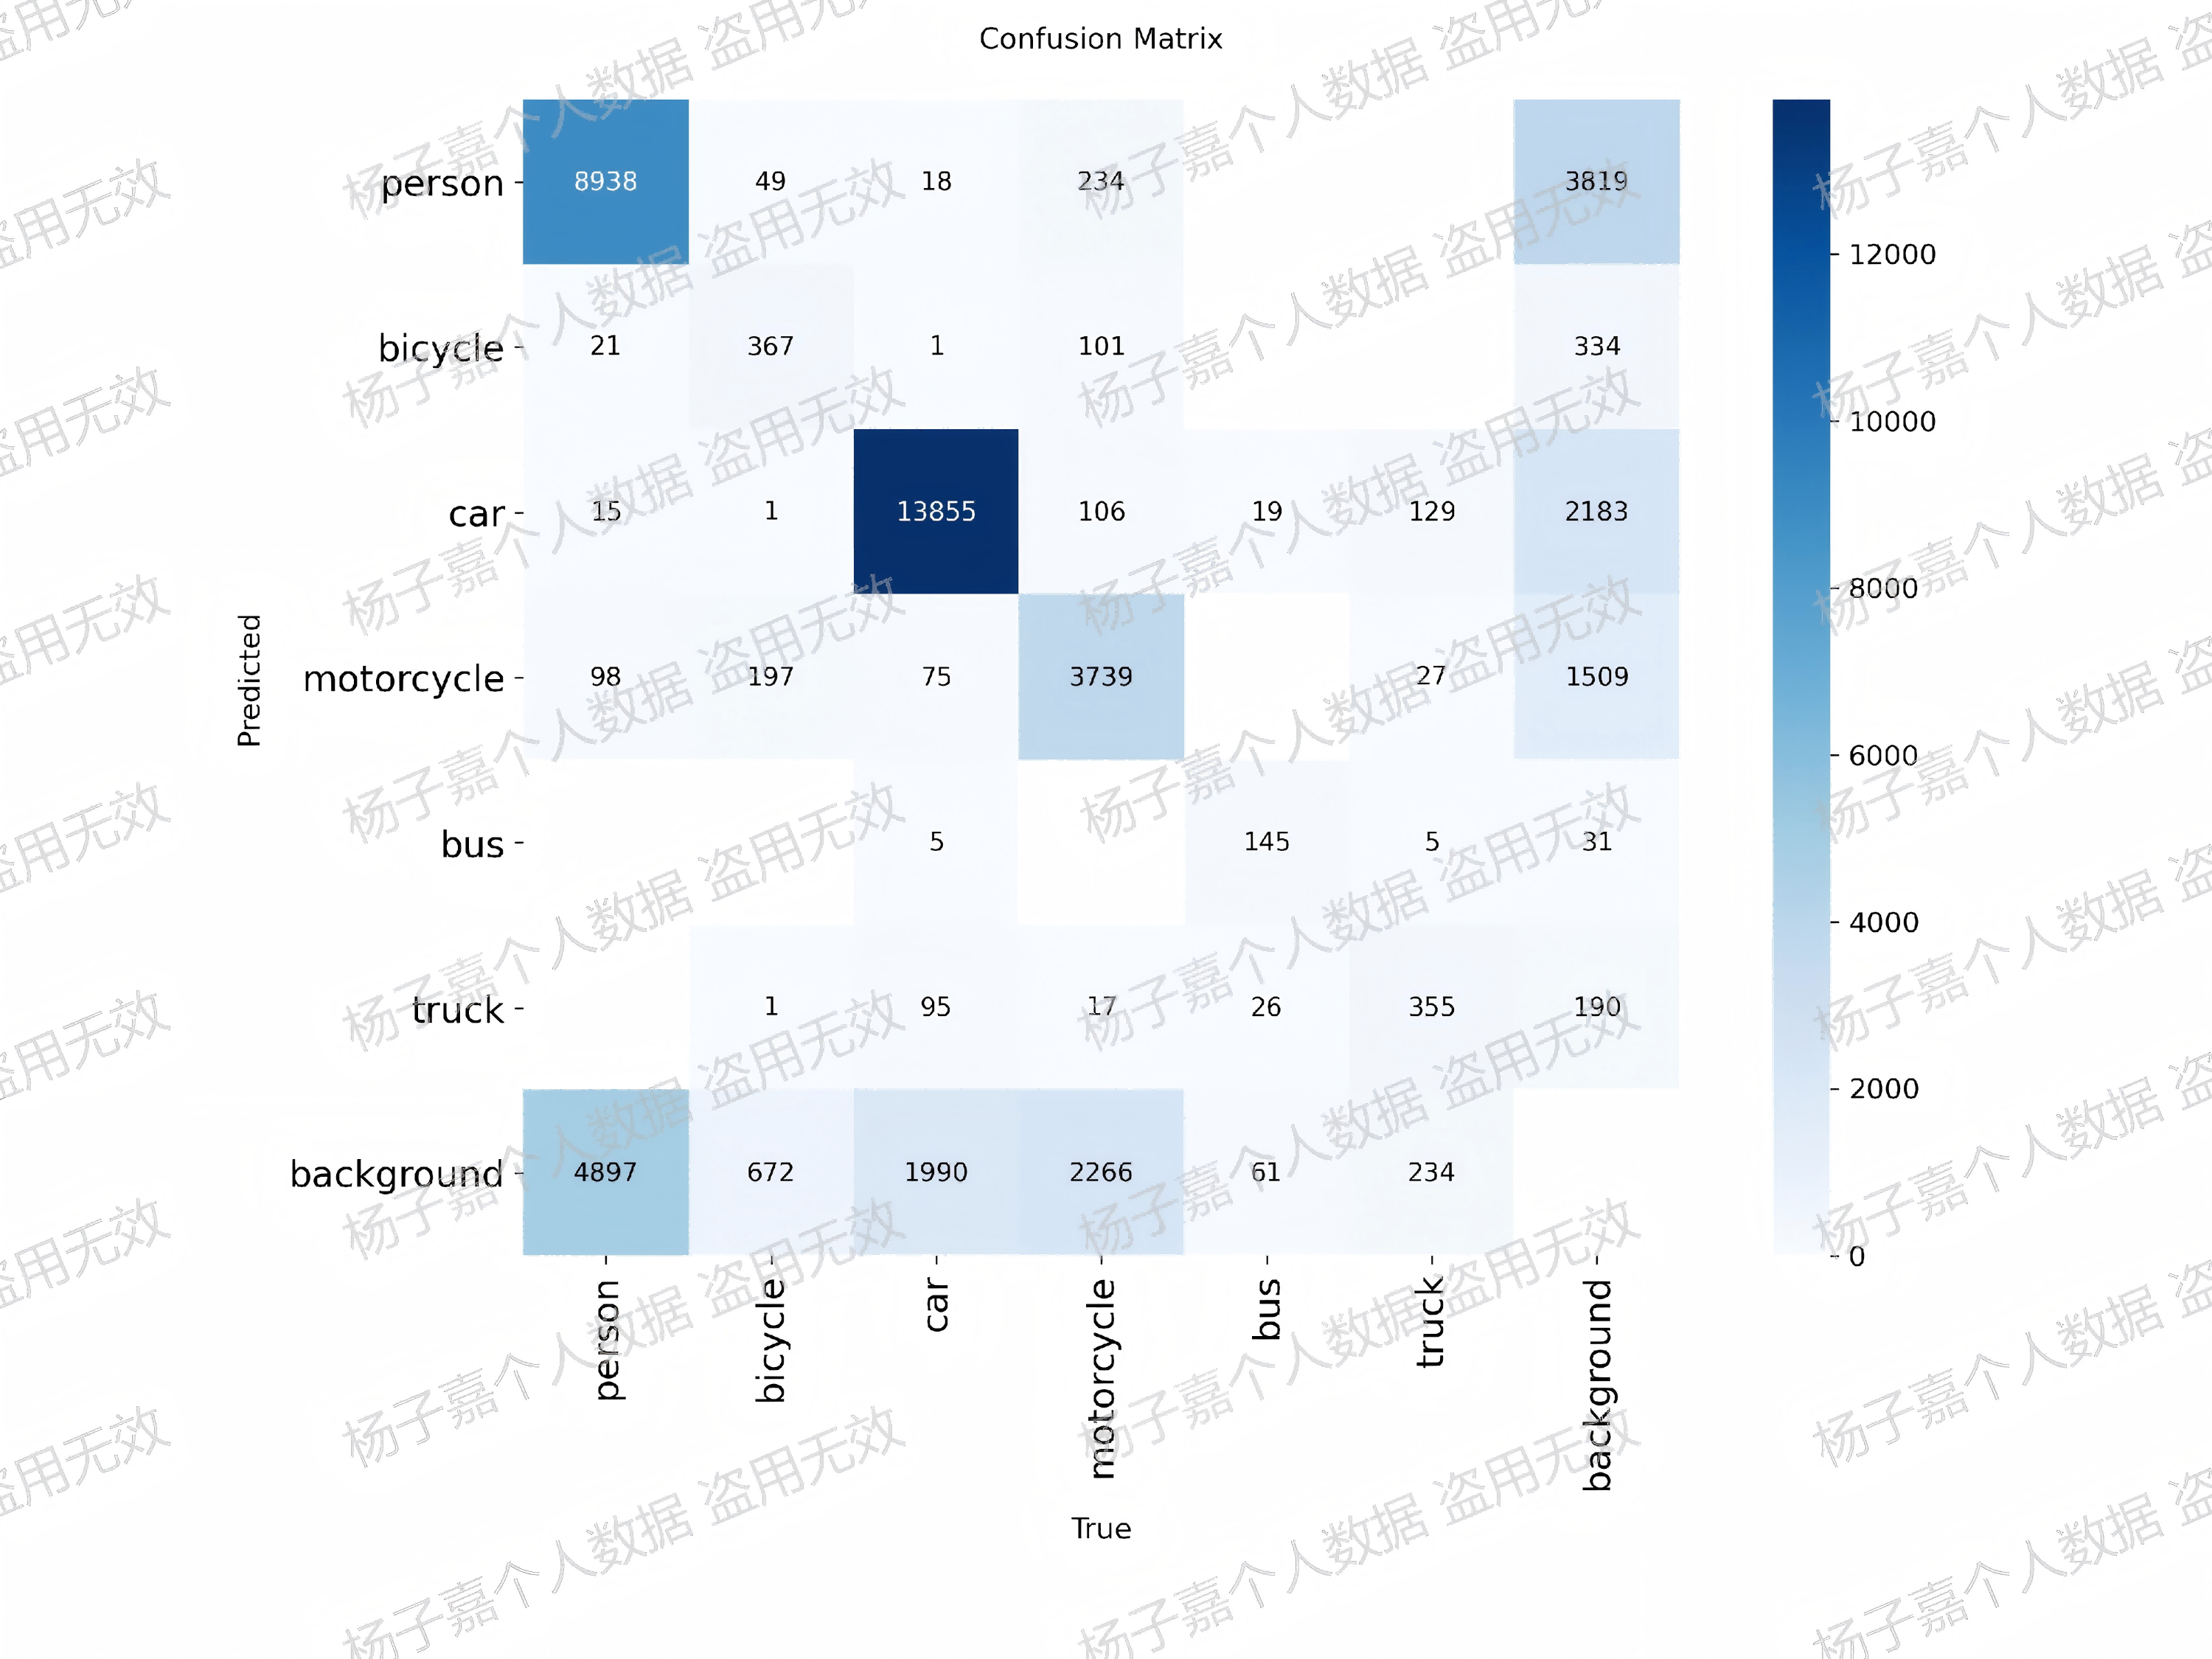
模型对主要类别(汽车和行人)具有极高的识别能力。其中 car 类别的对角线数值最高(13855),person 类别也达到了 8938 的正确识别数。但在密集小目标场景下,模型仍存在一定的误检与漏检:
- 漏检:真实为 person 的样本中,有 4897 个被预测为 background,漏检率约 35%。
- 误检:预测为 person 的结果中,有 3819 个实际为 background。
- 类间混淆:bicycle 有 334 个被误判为 motorcycle,truck 有 95 个被误判为 car,源于高空俯视下轮廓高度相似。
4.4 可视化结果展示
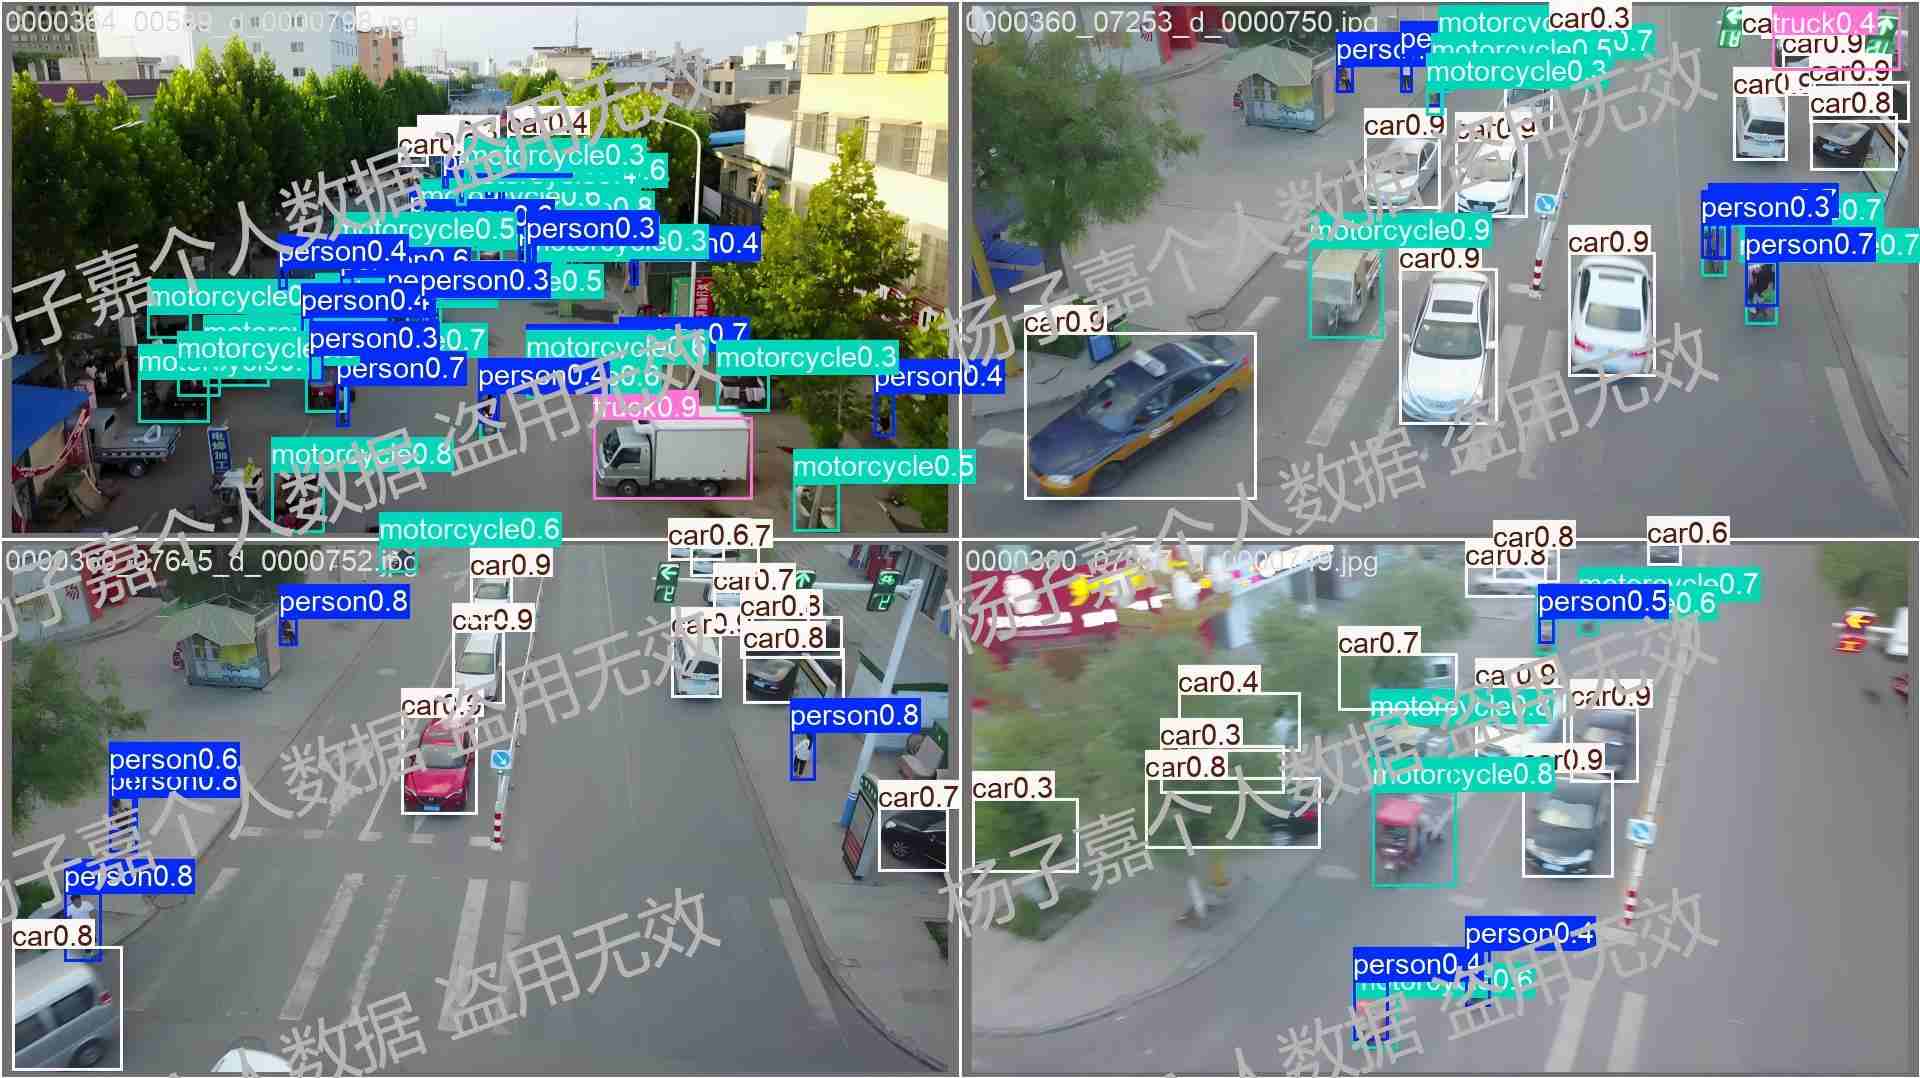
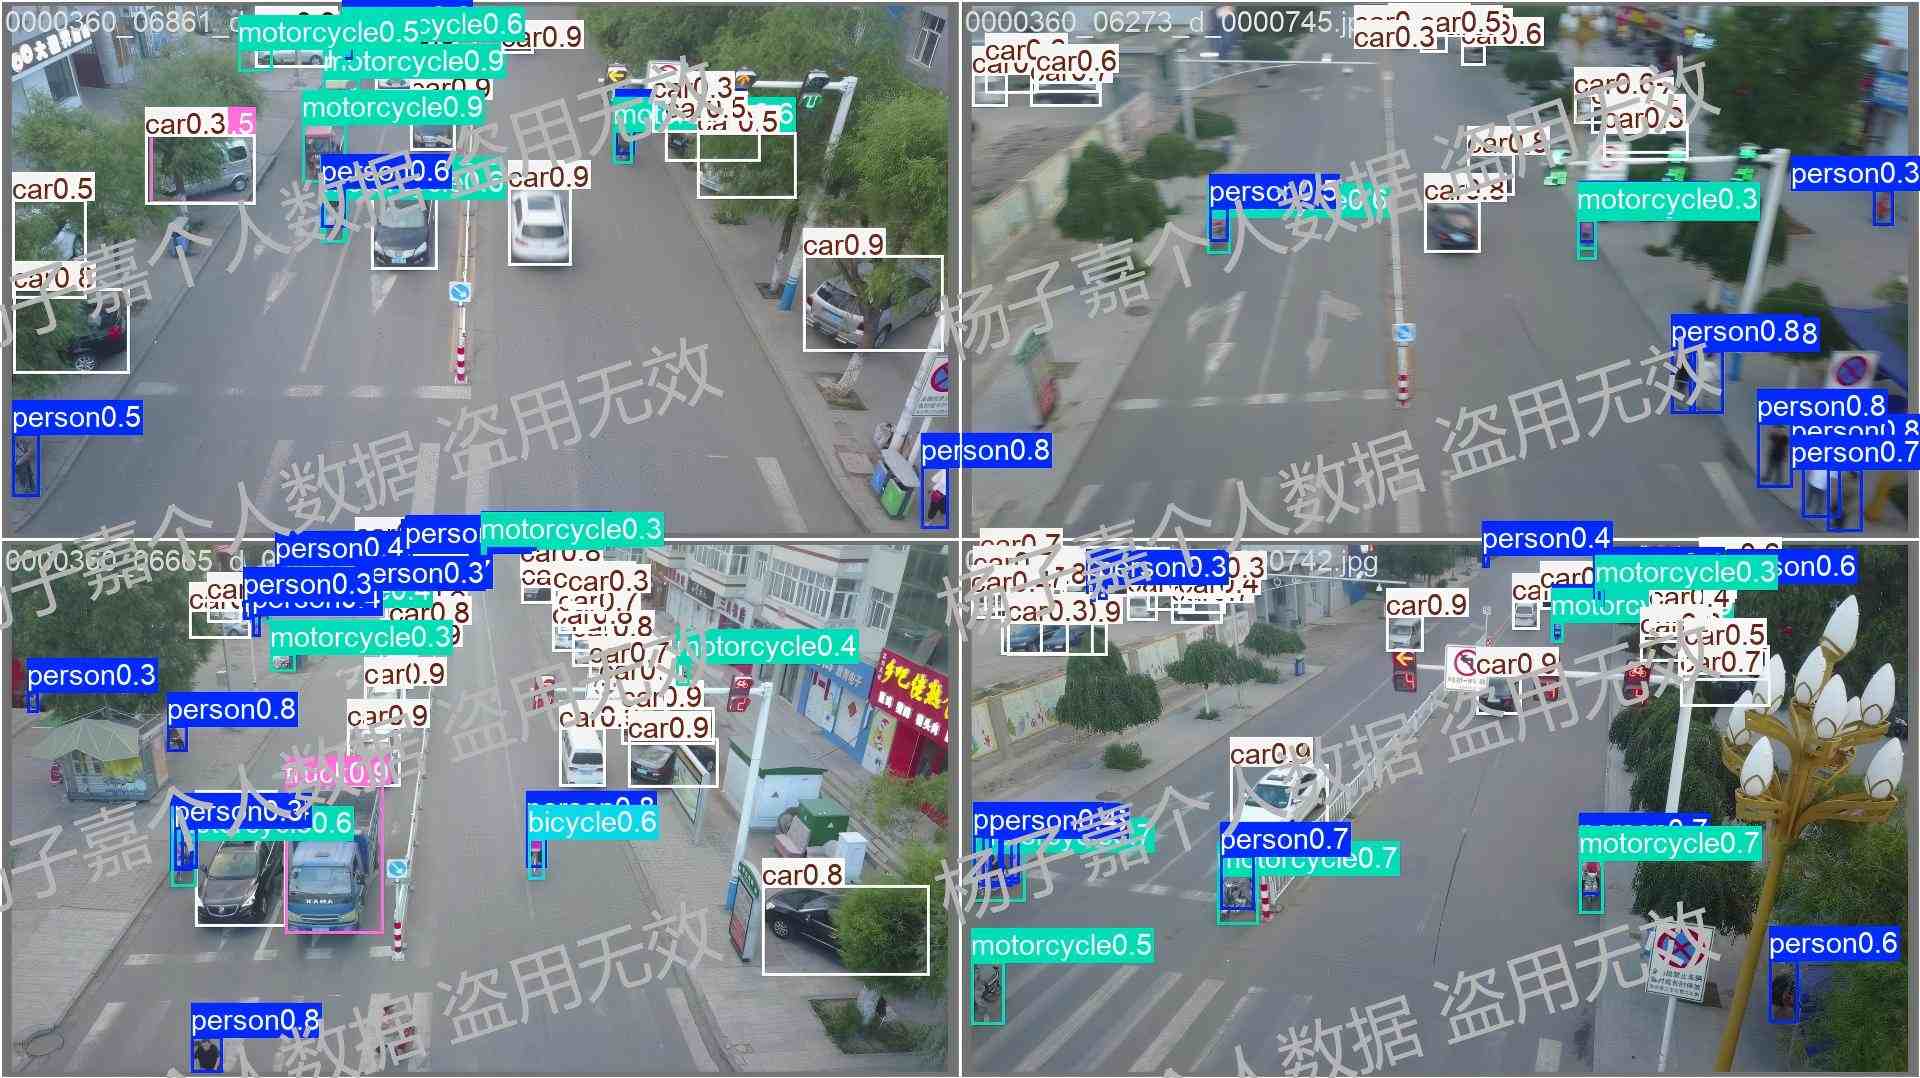
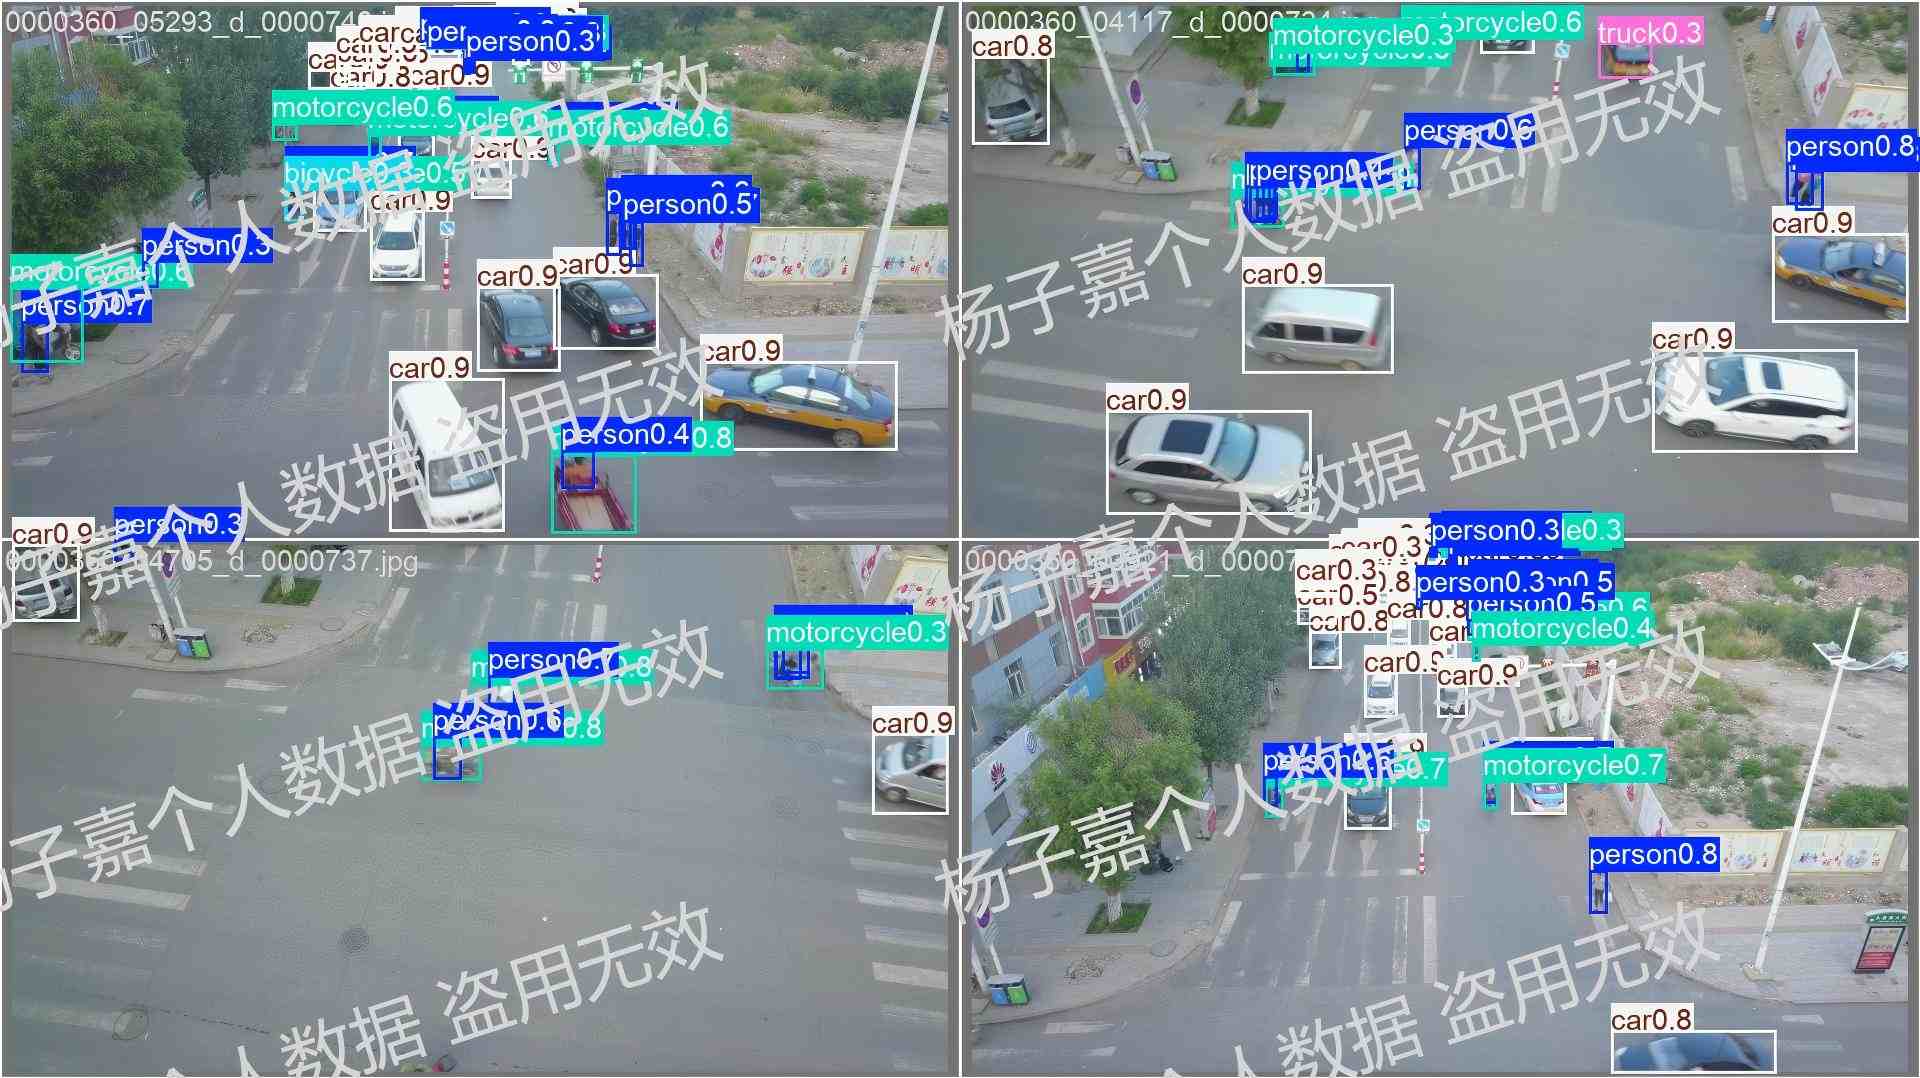
模型在极其密集的场景下表现出色,画面中包含大量相互遮挡的摩托车、行人和汽车,部分目标仅有十几个像素大小,模型不仅精准地定位了这些目标,还给出了较高的置信度分数。
5. 结论与展望
5.1 结论
- 受限算力下的高精度微调策略有效:通过轻量级 YOLO11s + 1280 分辨率 + batch=2 + AMP,成功在 8GB 显存下完成稳定训练。
- 断点续训展现极强的工程鲁棒性:分三阶段完成,每次加载 best.pt 重启后均能在数轮内恢复并持续爬升。
- YOLOE 架构在小目标任务上存在局限:文本对齐模型在极度密集的小目标数据集上对超参数较为敏感,其失败根因仍有待消融实验验证。
5.2 未来工作
- 引入 SAHI 切片推理:将高分辨率原图切分为多个重叠子图分别检测后再合并,降低边缘小目标漏检率。
- 模型量化与边缘端部署:采用 TensorRT 进行 FP16/INT8 量化,满足无人机机载嵌入式设备的实时性要求。
- 开发可视化 Web Demo:基于 Gradio 或 Streamlit 封装模型,支持图片/视频上传的交互式演示。